목적
- 과도한 트래픽을 방지하여 서비스 안정성을 유지 합니다.
- 특정 클라이언트가 서버 자원을 독점하지 못하도록 공정하게 분배합니다.
- 개발, 운영, 유료 키 등 차등 정책 적용
알고리즘
보통 아래 4가지 알고리즘으로 구현할 수 있다.
- Token Bucket: 가용한 토큰 개수만큼 요청 처리
- Leaky Bucket: 일정한 속도 요청 처리
- Fixed Window: 고정 간격 당 요청 수 제한
- Sliding Window: Fixed Window 알고리즘의 경계 문제를 해결
Fixed Window 알고리즘
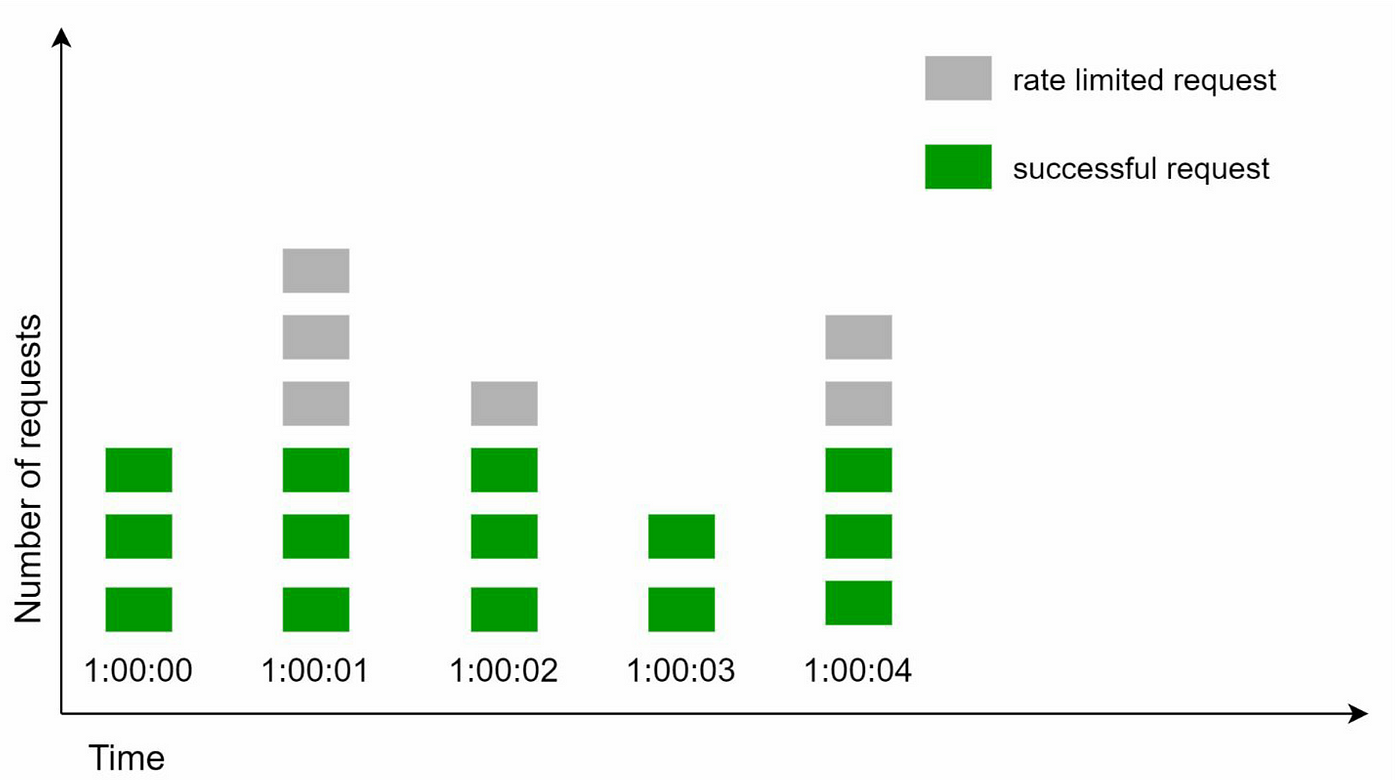
- 일정 시간 동안의 API 호출 횟수를 제한하는 방식입니다.
- 특정 시간 간격(예: 1분, 1시간)마다 허용된 최대 API 호출 횟수를 미리 정의하고, 해당 시간 간격 내에서 허용된 횟수를 초과하는 API 호출을 거부합니다.
![fixed_window]()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import time

class FixedWindowRateLimiter:
    def __init__(self, limit, window_size):
        self.limit = limit
        self.window_size = window_size
        self.timestamps = []

    def allow_request(self):
        current_time = time.time()
        # 윈도우 크기를 초과한 이전 타임스탬프 제거
        self.timestamps = [ts for ts in self.timestamps if ts >= current_time - self.window_size]
        if len(self.timestamps) < self.limit:
            self.timestamps.append(current_time)
            return True
        return False

# 예제 실행
rate_limiter = FixedWindowRateLimiter(limit=3, window_size=60)  # 1분 동안 최대 3개의 API 호출 허용
for i in range(10):
    if rate_limiter.allow_request():
        print(f"Request {i+1}: Allowed")
    else:
        print(f"Request {i+1}: Rejected")
    time.sleep(10)  # 요청 간격을 시뮬레이션하기 위해 10초 대기
장점
- 구현이 쉽습니다.
- 윈도우 단위로 요청 수 제어가 정확합니다.
단점
- 이전 시간 간격에서 미 사용된 허용량이 낭비 됩니다.
- 기간 경계의 트래픽 편향 발생
- 경계 시간대에 burst traffic 발생 가능
Sliding Window 알고리즘
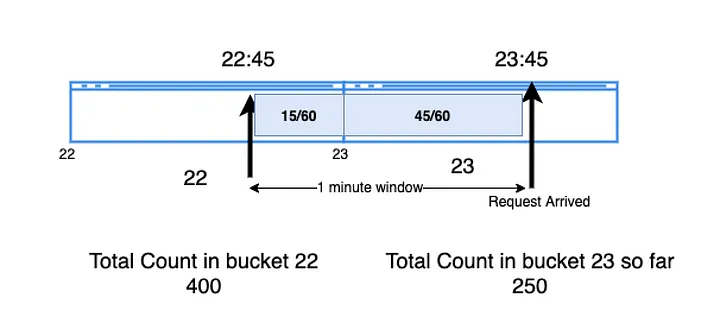
- 고정된 시간 간격 대신 슬라이딩 윈도우를 사용하여 API 호출을 제한하는 방식입니다.
- 슬라이딩 윈도우는 고정된 시간 간격을 유지하면서, 특정 시간 간격 내에서 API 호출 횟수를 허용합니다.
![sliding_window]()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import time

class SlidingWindowRateLimiter:
    def __init__(self, limit, window_size):
        self.limit = limit
        self.window_size = window_size
        self.timestamps = []

    def allow_request(self):
        current_time = time.time()
        # 윈도우 크기를 초과한 이전 타임스탬프 제거
        self.timestamps = [ts for ts in self.timestamps if ts >= current_time - self.window_size]
        if len(self.timestamps) < self.limit:
            self.timestamps.append(current_time)
            return True
        return False

# 예제 실행
rate_limiter = SlidingWindowRateLimiter(limit=5, window_size=60)  # 1분 동안 최대 5개의 API 호출 허용
for i in range(10):
    if rate_limiter.allow_request():
        print(f"Request {i+1}: Allowed")
    else:
        print(f"Request {i+1}: Rejected")
    time.sleep(10)  # 요청 간격을 시뮬레이션하기 위해 10초 대기
장점
- Fixed Window의 기간 경계 편향 문제를 해결하여 Burst traffic 을 방지할 수 있습니다.
단점
- 이전 윈도우에서 사용된 요청 정보를 모두 가지고 있어야 하기 때문에 상대적으로 메모리 사용량이 높아집니다.
- 대규모 트래픽 대응에 적절하지 않습니다.
Leaky Bucket 알고리즘
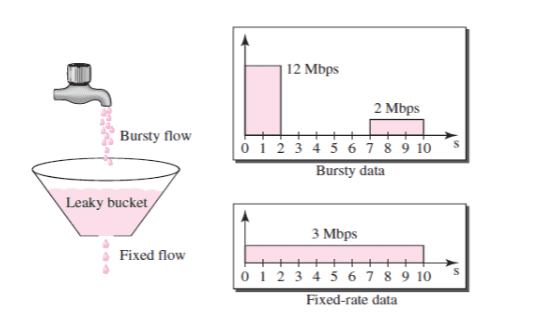
- Leaky Bucket 알고리즘은 버킷에 요청을 저장하고, 일정 속도로 누수되도록 합니다.
- 새 요청이 오면 버킷에 저장되고 누수되는 속도에 따라 처리됩니다.
- 버킷이 가득 찬 경우 추가 요청은 거부 됩니다.
- Leaky Bucket 알고리즘은 간단한 구현과 부하 분산 측면에서 유용할 수 있습니다.
- 토큰이 남아있더라도 속도에 따라 제한이 된다는 것이 Token Bucket 과의 차이점입니다.
![leaky_bucket]()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import time
from collections import deque

class LeakyBucketRateLimiter:
    def __init__(self, capacity, rate):
        self.capacity = capacity
        self.rate = rate
        self.bucket = deque()
        self.last_leak_time = int(time.time())

    def allow_request(self):
        current_time = int(time.time())
        time_since_last_leak = current_time - self.last_leak_time
        leaked_tokens = time_since_last_leak * self.rate

        if leaked_tokens > 0:
            self.bucket.extendleft([None] * int(leaked_tokens))
            self.last_leak_time = current_time

        if len(self.bucket) < self.capacity:
            self.bucket.append(None)
            return True
        return False

# 예제 실행
rate_limiter = LeakyBucketRateLimiter(capacity=5, rate=2)  # 1초에 최대 2개의 API 호출 허용

for i in range(1, 11):
    if rate_limiter.allow_request():
        print(f"Request {i}: Allowed")
    else:
        print(f"Request {i}: Rejected")
    time.sleep(0.5)  # 요청 간격을 시뮬레이션하기 위해 0.5초 대기
장점
- 일정한 속도로 요청 처리 가능합니다.
단점
- Token Bucket 방식에 비해 유연함은 떨어집니다. (Burst 불가능)
Token Bucket 알고리즘
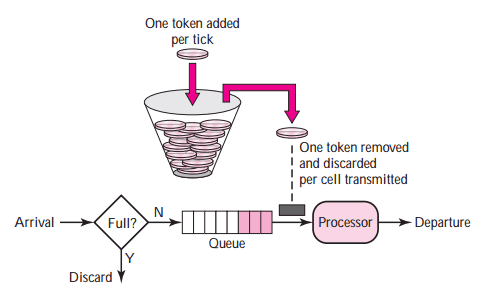
- 일정량의 토큰을 버킷에 저장하고, 각 API 호출이 특정 토큰을 소비하는 방식으로 동작합니다.
- 버킷에 토큰이 있는 한 API 호출을 수행할 수 있으며, 토큰이 부족한 경우 일정 속도로 토큰이 추가됩니다.
- Token Bucket 알고리즘은 유연성과 예측 가능성 면에서 우수한 성능을 보이며, 다양한 시나리오에 적용할 수 있습니다.
![token_bucket]()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import time

class TokenBucket:
    def __init__(self, capacity, rate):
        self.capacity = capacity
        self.rate = rate
        self.tokens = capacity
        self.last_time = time.time()

    def _get_tokens(self):
        now = time.time()
        elapsed_time = now - self.last_time
        tokens_to_add = elapsed_time * self.rate
        self.tokens = min(self.tokens + tokens_to_add, self.capacity)
        self.last_time = now

    def allow_request(self):
        self._get_tokens()
        if self.tokens >= 1:
            self.tokens -= 1
            return True
        return False

# 예제 실행
bucket = TokenBucket(capacity=10, rate=1)  # 버킷 용량 10, 초당 1개 토큰 생성
for i in range(15):
    if bucket.allow_request():
        print(f"Request {i+1}: Allowed")
    else:
        print(f"Request {i+1}: Rejected")
    time.sleep(0.5)  # 요청 간격을 시뮬레이션하기 위해 0.5초 대기
장점
- 토큰이 남아있다면 Burst 요청이 가능합니다.
단점
- 초기에 버킷에 충분한 토큰이 생성되어 있지 않으면 처음 몇 번의 API 호출이 제한될 수 있습니다. 이로 인해 초기 지연이 발생할 수 있습니다.
- 버킷 용량을 초과한 사용량은 버려집니다.